Ketika laboratorium AI merilis model flagship teranyar, diskursus publik kerap didominasi oleh dua respons ekstrem: euforia berlebihan di hari peluncuran atau sinisme di hari ketiga karena pengguna mengujinya dengan pertanyaan sepele satu langkah. Menguji model penalaran berat seperti Claude Opus 5.5 dengan meminta ringkasan artikel pendek atau takarir media sosial tidak akan memperlihatkan keunggulan arsitekturnya.
Claude Opus 5.5 dibangun secara spesifik untuk pekerjaan rekayasa perangkat lunak otonom, analisis dokumen multi-sumber, dan komputasi jangka panjang (long-running agentic tasks). Tulisan ini membedah seberapa kuat model ini secara faktual, apa saja pekerjaan nyata yang sanggup diselesaikannya, bagaimana arsitektur harga dan parameter effort bekerja, serta bagaimana membuktikan kapasitasnya melalui skenario pengujian mandiri yang terukur.
1. Spesifikasi Dasar dan Yang Berubah dari Opus 5
Berdasarkan dokumentasi resmi Anthropic, Claude Opus 5.5 dirilis sebagai model frontier teratas mereka untuk beban kerja penalaran kompleks. Model ini dirancang untuk menyamai atau melampaui performa Claude Fable 5.1 pada sebagian besar pengujian teknis, sembari memangkas biaya komputasi hingga 40 persen lebih hemat dibandingkan pendahulunya, Opus 5.
Berikut adalah spesifikasi inti dari Claude Opus 5.5:
- Model Identifier:
claude-opus-5-5 - Jendela Konteks (Context Window): 1.000.000 token (1M token)
- Keluaran Maksimum (Max Output): 128.000 token (128k token)
- Batas Pengetahuan (Knowledge Cutoff): Hingga Juni 2026
- Ketersediaan Infrastruktur: Claude API, Anthropic Console, AWS Bedrock, Google Cloud Vertex AI, dan Microsoft Foundry
- Kecepatan Inferensi: Waktu generasi token keluaran lebih dari 30 persen lebih cepat dibanding Opus 5
- Pembaruan Penggunaan Konsumen: Kuota batas pesan 5 jam dinaikkan untuk paket Pro, Max, Team, dan Enterprise, disertai fasilitas satu kali rate limit reset simpanan
Perubahan paling substansial bukan sekadar angka kecepatan generasi teks, melainkan penurunan jumlah langkah (turns) yang diperlukan model untuk menuntaskan sebuah instruksi rekayasa kode yang rumit.
2. Data Benchmark Resmi Vendor
Agar analisis ini berpijak pada data dan bukan klaim pemasaran abstrak, berikut adalah perolehan skor benchmark resmi yang dipublikasikan oleh Anthropic saat peluncuran Claude Opus 5.5.
Catatan Validitas Data: Seluruh metrik pada tabel berikut merupakan angka yang dilaporkan oleh pihak vendor (Anthropic). Angka ini mencerminkan batas atas kemampuan model pada lingkungan evaluasi sintetis terstandarisasi, bukan jaminan performa mutlak pada basis kode atau beban kerja spesifik organisasi Anda.
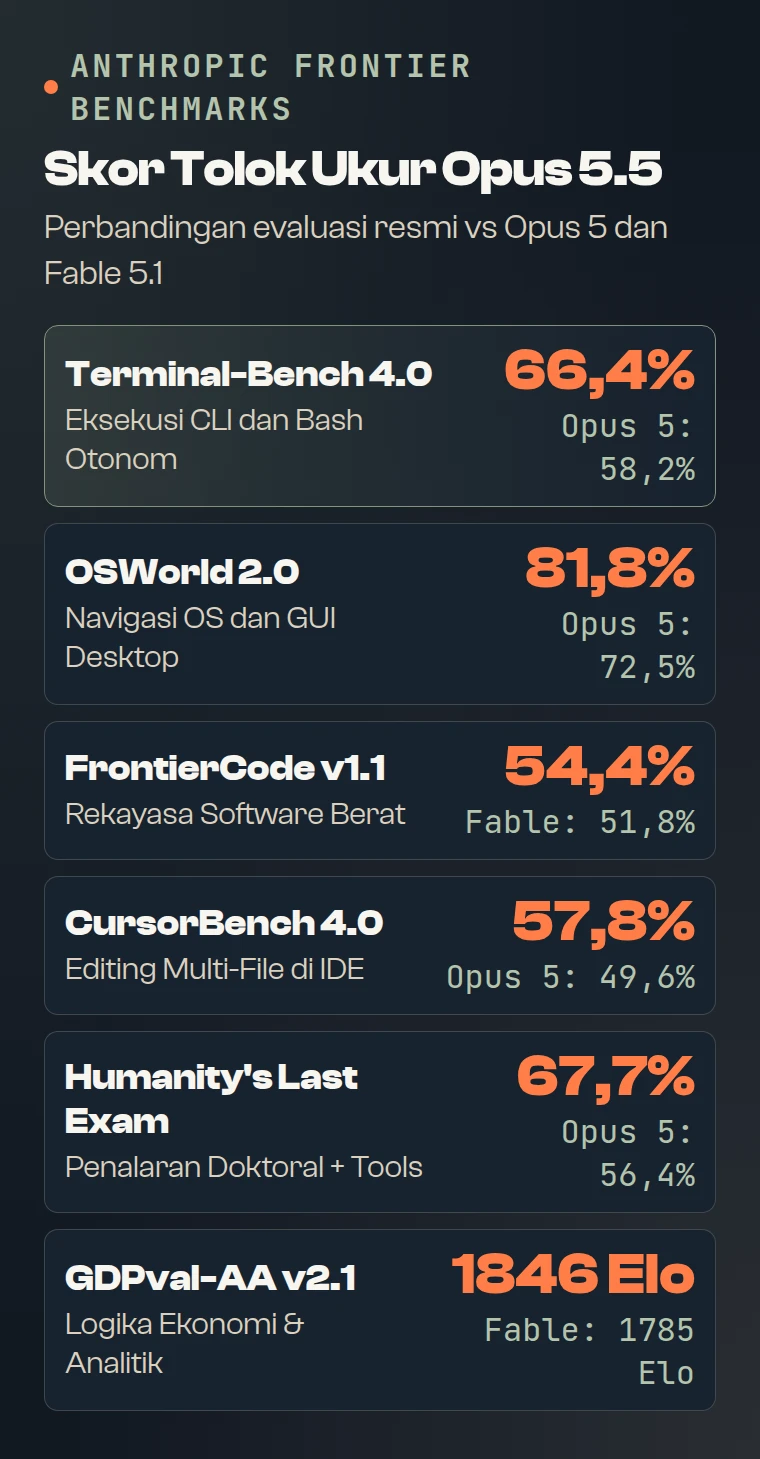
| Tolok Ukur (Benchmark) | Skor Opus 5.5 | Domain Pengujian | Makna Praktis bagi Rekayasa Sistem |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | Eksekusi CLI & bash otonom | Menuntaskan tugas administrasi server dan shell dengan langkah lebih sedikit |
| OSWorld 2.0 | 81,8% | Navigasi antarmuka OS & aplikasi | Kemampuan mengoperasikan GUI desktop dan browser via perintah multimodal |
| FrontierCode v1.1 | 54,4% | Masalah rekayasa software berat | Pemecahan algoritma tingkat lanjut dan debugging basis kode skala enterprise |
| CursorBench 4.0 | 57,8% | Integrasi alur kerja IDE coding | Akurasi pengeditan multi-file dan pemahaman repositori lokal |
| Humanity’s Last Exam | 67,7% (tools) | Penalaran akademik multi-disiplin | Sintesis pengetahuan tingkat doktoral dengan bantuan pemanggilan modul alat |
| GDPval-AA v2.1 | 1846 Elo | Kemampuan penalaran ekonomi & logika | Stabilitas penalaran analitis dalam skenario perancangan kebijakan dan bisnis |
Pada Terminal-Bench 4.0, Anthropic mencatat bahwa Claude Opus 5.5 mampu menyelesaikan lebih banyak tugas dibanding Opus 5 dengan menggunakan kurang dari separuh jumlah langkah eksekusi. Penurunan turn ini adalah faktor kunci di balik efisiensi riil model.
3. Struktur Biaya: Mengapa Penurunan Biaya Riil Lebih Besar dari Harga Stiker
Biaya penggunaan model AI sering disalahartikan hanya dengan melihat perbandingan tarif input dan output per satu juta token. Pada Claude Opus 5.5, penurunan tarif nominal adalah 20 persen, namun penghematan total pada pekerjaan dunia nyata diklaim mencapai 40 persen.
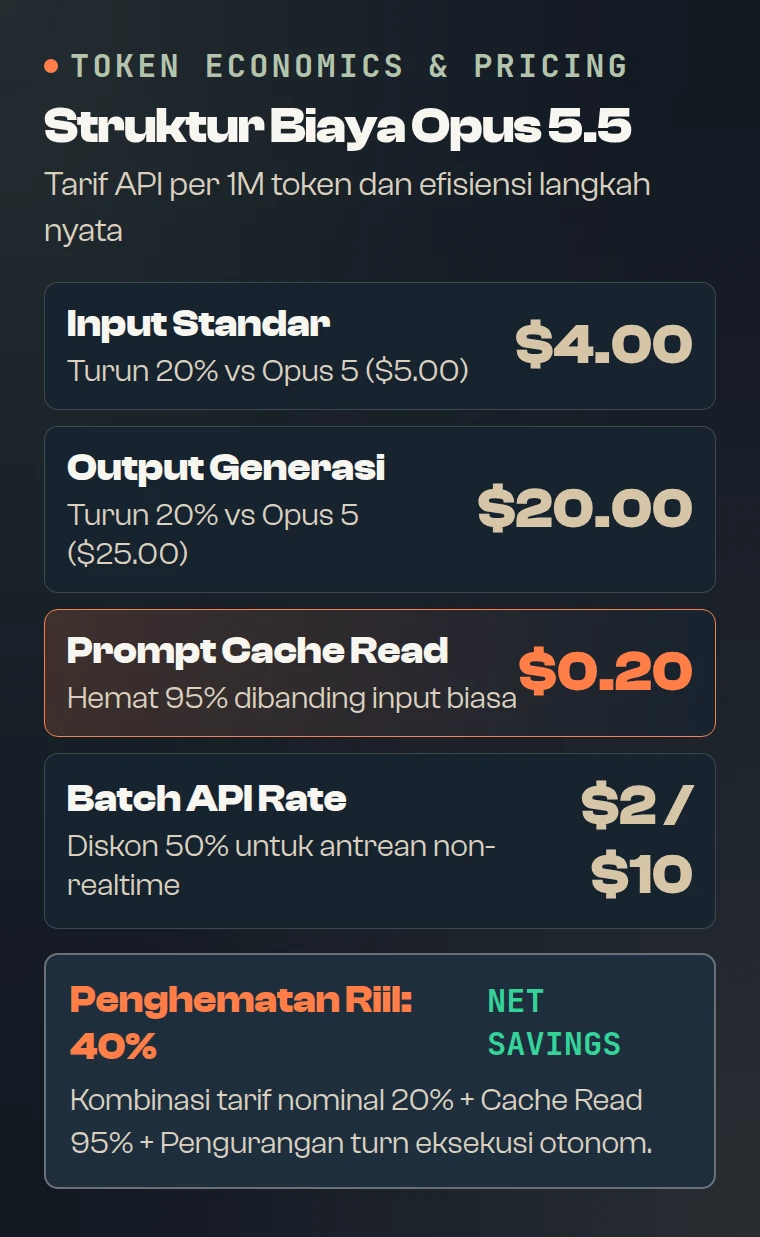
Tabel perbandingan biaya resmi per 1 juta token:
| Model AI | Input Biasa | Output Generasi | Cache Read | Batch API (Input/Output) |
|---|---|---|---|---|
| Claude Fable 5.1 | $10,00 | $50,00 | $1,00 | $5,00 / $25,00 |
| Claude Opus 5 | $5,00 | $25,00 | $0,50 | $2,50 / $12,50 |
| Claude Opus 5.5 | $4,00 | $20,00 | $0,20 | $2,00 / $10,00 |
| Claude Sonnet 5 | $2,00 | $10,00 | $0,10 | $1,00 / $5,00 |
Analisis Penghematan Riil
Jika kita menghitung tugas pengkodean yang memerlukan 50.000 token input dan 8.000 token output:
- Pada Opus 5: (50k x $5/M) + (8k x $25/M) = $0,25 + $0,20 = $0,45 per eksekusi.
- Pada Opus 5.5: (50k x $4/M) + (8k x $20/M) = $0,20 + $0,16 = $0,36 per eksekusi (turun 20%).
Sisa penghematan menuju 40 persen didapatkan dari fakta bahwa Opus 5.5 memerlukan lebih sedikit interaksi bolak-balik untuk mencapai kode yang berfungsi (zero-shot compile atau fewer turn repairs). Selain itu, tarif pembacaan prompt cache dipangkas 60 persen (dari $0,50 ke $0,20), yang membuat sistem agen otonom berbasis loop context caching menjadi jauh lebih ekonomis.
4. Mekanisme Alokasi Penalaran (Effort Tuning)
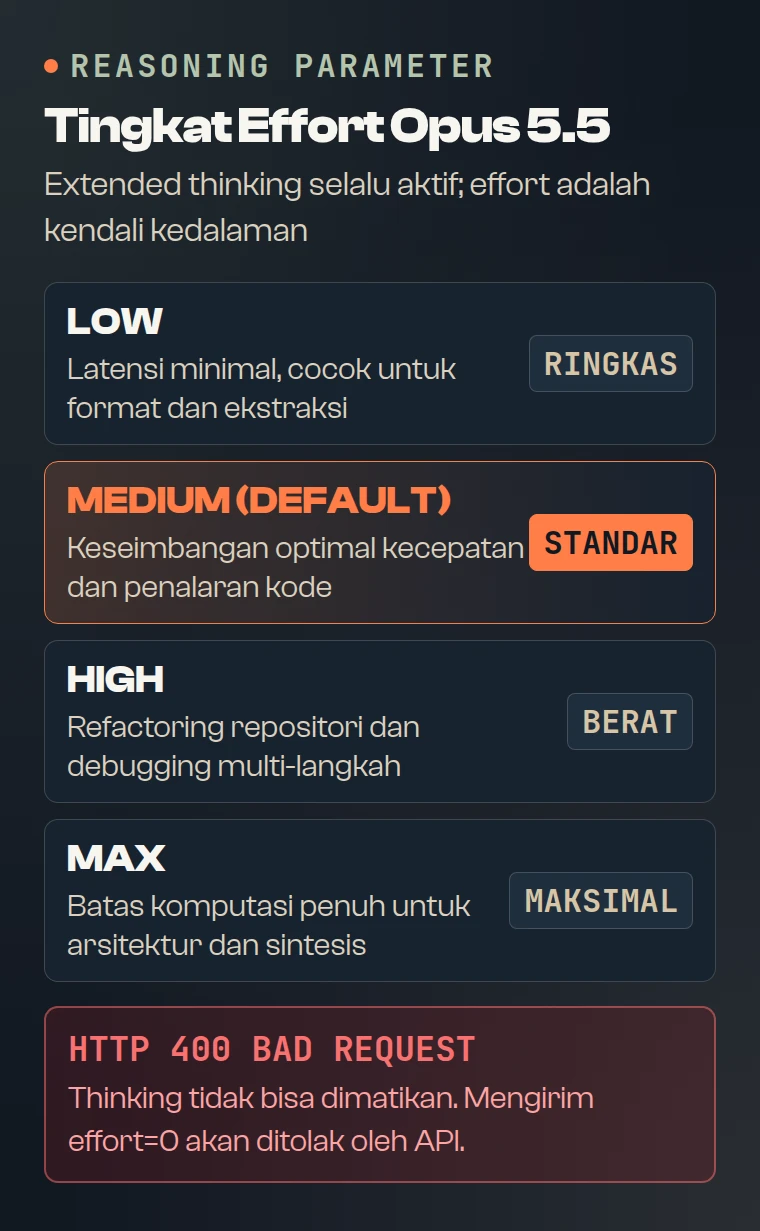
Pada Claude Opus 5.5, fitur penalaran mendalam (extended thinking) berstatus selalu aktif. Anda tidak dapat mematikan proses berpikir ini; permintaan API yang mengirimkan parameter penonaktifan thinking secara paksa akan ditolak dengan galat status HTTP 400.
Sebagai gantinya, kedalaman berpikir diatur secara eksklusif melalui parameter effort. Terdapat lima tingkat alokasi:
| Tingkat Effort | Karakteristik Komputasi | Rekomendasi Beban Kerja |
|---|---|---|
| Low | Penalaran singkat, latensi minimum, hemat token | Ekstraksi format dokumen, klasifikasi cepat, audit angka terstruktur |
| Medium (Default) | Keseimbangan optimal logika dan kecepatan | Sebagian besar tugas rekayasa kode, refactoring, riset dokumen |
| High | Eksplorasi solusi bercabang, penalaran multi-sudut | Debugging arsitektur sistem, audit keamanan dependensi kompleks |
| XHigh | Analisis ketat terhadap kontradiksi dan ambiguitas | Pembuktian logika matematis, audit kepatuhan hukum dan regulasi |
| Max | Alokasi komputasi mendalam penuh, latensi tertinggi | Pemecahan teka-teki logika berat yang belum terpecahkan |
Perubahan Kebiasaan: Default Opus 5.5 berpindah dari
high(standar lama pada Opus 5) kemedium. Dalam pengujian Anthropic, Opus 5.5 pada level medium telah melampaui performa Opus 5 pada level high untuk beban kerja coding. Jangan menaikkan parameter ke max tanpa bukti terukur bahwa hasil pada level medium tidak mencukupi.
5. Lima Pekerjaan Teknis yang Sekarang Terbuka
Bukan sekadar pertanyaan “apakah model ini lebih pintar”, tolok ukur esensial adalah pekerjaan apa yang sebelumnya mustahil atau terlalu mahal untuk diotomatisasi, kini menjadi masuk akal untuk dikerjakan.
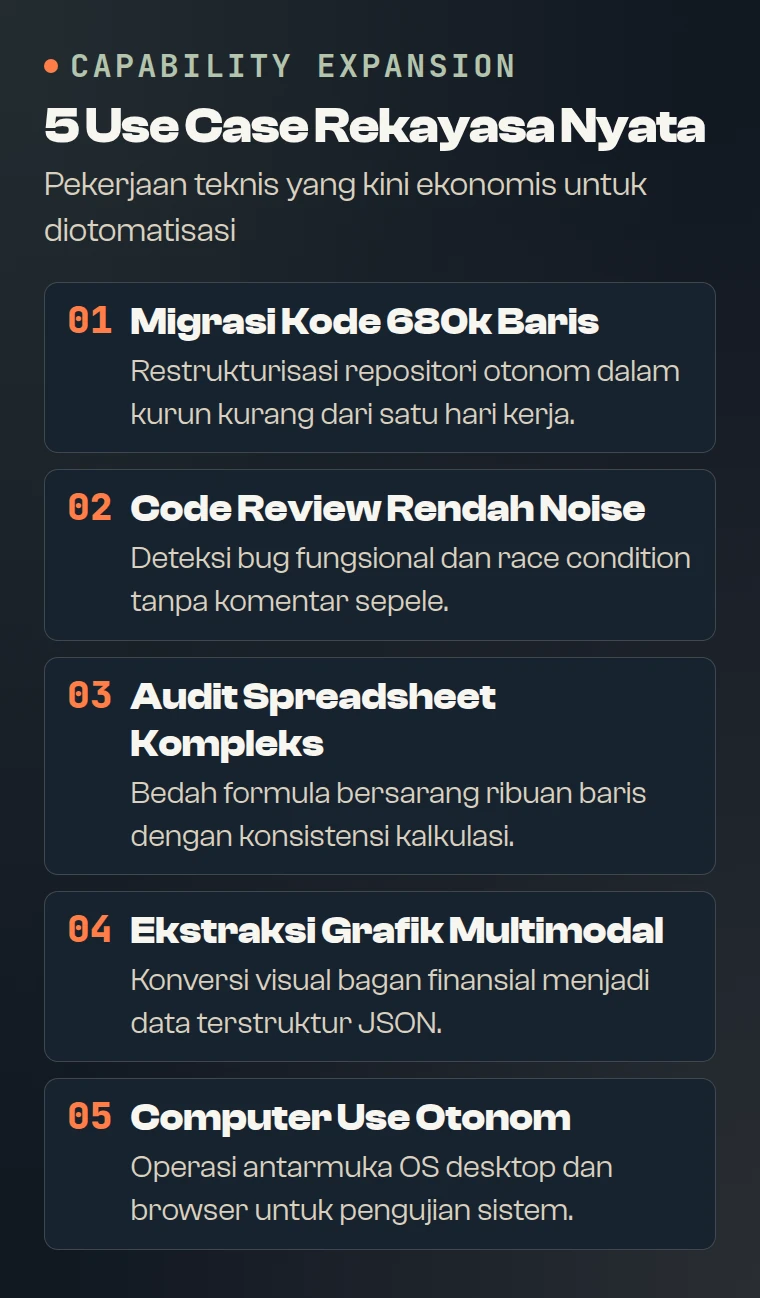
1. Migrasi dan Refactoring Basis Kode Besar Mandiri
Pada model generasi sebelumnya, memerintahkan restrukturisasi modul besar sering terputus di tengah jalan karena degradasi konteks. Laporan penguji awal vendor mencatat keberhasilan migrasi repositori hingga 680 ribu baris kode dalam kurun waktu kurang dari satu hari kerja dengan membagi peran ke beberapa subagent. Opus 5.5 sanggup mempertahankan peta referensi variabel global dan penamaan konvensi tanpa pengawasan manual menit demi menit.
2. Tinjauan Kode (Code Review) yang Bebas Kebisingan
Banyak perkakas tinjauan AI ditinggalkan pengembang karena menghasilkan puluhan peringatan palsu (false positives). Opus 5.5 menunjukkan kemampuan membedakan gaya penulisan personal dari bug fungsional yang sebenarnya, seperti potensi memory leak atau race condition tersembunyi, sehingga hasil review-nya actionable bagi tim engineering.
3. Audit Spreadsheet dan Model Keuangan
Pada simulasi evaluasi firma investasi, model ini mampu menemukan kesalahan formula indexing dan kalkulasi baris yang terlewat oleh model-model sebelumnya, bahkan saat dijalankan pada setelan effort terendah (low). Model memeriksa relasi dependensi sel secara struktural, bukan sekadar membaca angka visual.
4. Ekstraksi Bagan dan Grafik Padat Tanpa Optical OCR Tambahan
Model sanggup membaca angka-angka kecil pada bagan pencar (scatter plot), diagram alir, dan tangkapan layar dasbor yang padat dengan tingkat akurasi tinggi pada effort default, tanpa memerlukan pipeline pra-pemrosesan gambar khusus.
5. Pengoperasian Aplikasi Desktop dan Browser (Computer Use)
Melalui protokol antarmuka komputer (computer toolset), Opus 5.5 dapat mengamati tangkapan layar desktop, merencanakan urutan klik mouse dan ketukan keyboard, serta mengoreksi tindakannya jika jendela aplikasi yang terbuka menampilkan status galat.
6. Empat Kesalahan Penggunaan yang Sering Terjadi
Jika Anda mencoba Opus 5.5 dan merasa hasilnya “tidak berbeda dengan model murah”, hampir dapat dipastikan salah satu dari empat kesalahan berikut sedang terjadi:
- Menguji dengan Pertanyaan Trivial: Menanyakan definisi istilah, rumus matematika sekolah, atau ringkasan email pendek. Seluruh model frontier telah menguasai hal tersebut sejak dua tahun lalu.
- Memaksa Parameter Effort Tertinggi: Langsung menyetel effort ke
maxhanya membuang kuota token thinking dan memperpanjang waktu tunggu tanpa memberikan perbaikan fungsi yang sebanding. - Memasukkan Frasa Prompt Usang: Instruksi seperti “think carefully step by step” atau “pikirkan baik-baik” kini redundan dan kontraproduktif. Mekanisme extended thinking internal telah bekerja secara independen. Menghapus frasa ini justru mempercepat respons model.
- Evaluasi Tanpa Kondisi Terkontrol: Membandingkan dua model dengan mengetik ulang prompt, mengubah susunan kalimat, atau menjalankan tes di dalam percakapan yang sudah memiliki riwayat konteks sebelumnya.
7. Tiga Skenario Pengujian Mandiri dan Prompt Orisinal
Untuk memverifikasi kekuatan Claude Opus 5.5 pada beban kerja Anda sendiri (bukan bersandar pada klaim pihak ketiga), jalankan tiga skenario pengujian di bawah ini dalam sesi obrolan yang terpisah dan bersih.
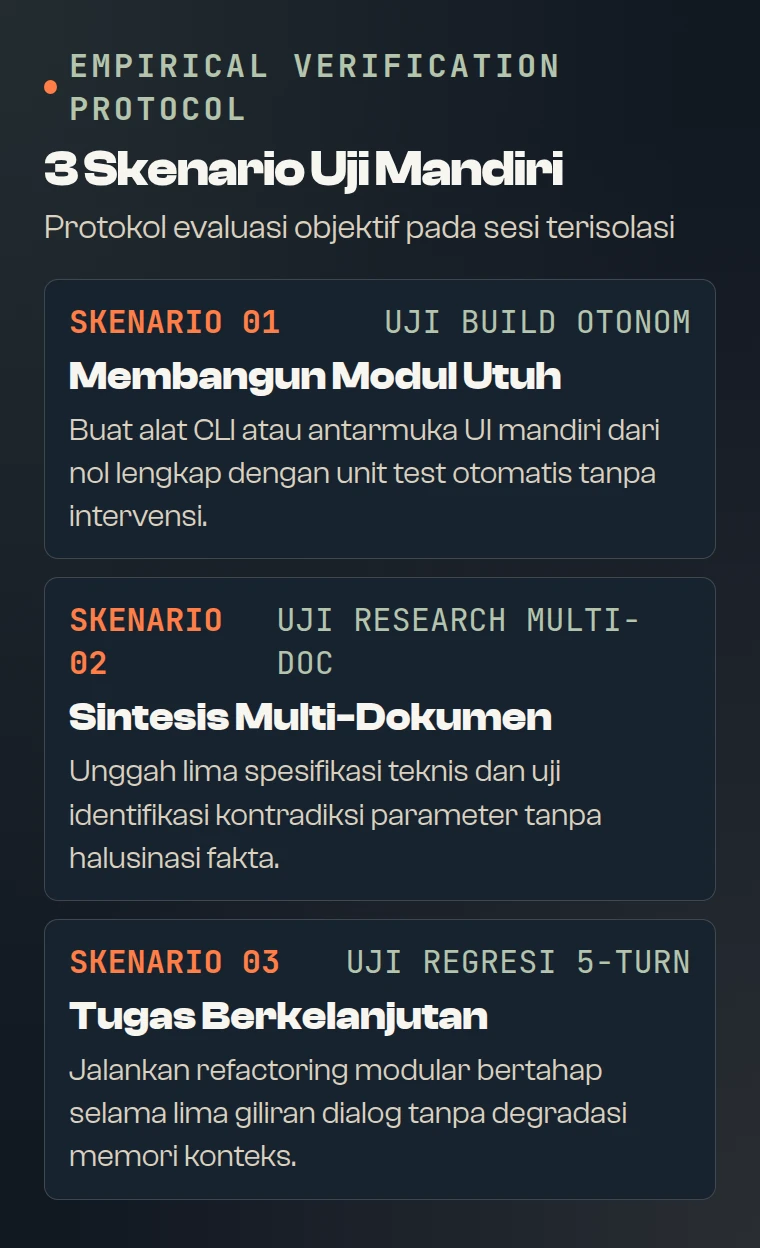
Skenario 1: BUILD (Rekayasa Modul Lengkap dari Brief Mentah)
Tujuan skenario ini adalah menguji kemampuan model menyaring brief ambigu, mengambil keputusan arsitektural secara mandiri, dan menghasilkan kode utuh yang siap dieksekusi.
Anda adalah senior software engineer. Saya memberikan brief mentah untuk pembuatan modul otomasi data. Tugas Anda adalah mengonversinya menjadi kode produksi yang lengkap dan siap dijalankan, bukan sekadar outline atau pseudocode.

ATURAN KERJA:
1. SPESIFIKASI: Rumuskan ulang brief ini menjadi spesifikasi ringkas: input, proses, output, batasan teknis, dan definisi selesai.
2. AMBIGUITAS: Jika ada maksimal 2 pertanyaan yang benar-benar memblokir fungsi sistem, ajukan sekarang secara presisi. Selain itu, ambil keputusan teknis paling kokoh secara mandiri dan tuliskan asumsi Anda. Jangan berhenti untuk menanyakan detail sepele.
3. KODE LENGKAP: Tuliskan kode utuh dengan penanganan error yang kuat. Jangan tinggalkan blok kosong seperti '// tambahkan logika di sini'.
4. AUDIT AKHIR: Tuliskan (a) bagian mana yang paling rentan jika volume data naik 100x, (b) satu keputusan desain yang Anda modifikasi dari brief awal beserta alasannya, dan (c) apa yang wajib diverifikasi manual sebelum deployment.

BRIEF MENTAH:
[Tempelkan brief proyek riil Anda, atau gunakan contoh: "Buat modul CLI TypeScript untuk membaca kumpulan file log JSON transaksi, menyaring error 5xx, menghitung persentase kegagalan per endpoint per jam, dan mengeluarkan ringkasan Markdown serta CSV terformat."]
Skenario 2: RESEARCH (Audit Kontradiksi dan Celah Bukti Multi-Dokumen)
Tujuan skenario ini adalah menguji kejujuran epistemik: apakah model berani menandai data yang rapuh, atau justru mengarang kesimpulan demi terlihat lengkap.
Berikut saya lampirkan cuplikan dari 4 sumber independen mengenai topik yang sama. Tugas Anda bukan merangkum dokumen satu per satu, melainkan menyusun peta kontradiksi data dan celah pembuktian.

Keluarkan analisis dalam 5 bagian berurutan:
1. KLAIM INTI: Daftar klaim faktual utama dengan label sumbernya masing-masing.
2. PASANGAN KONTRADIKSI: Format [Sumber A mengklaim X] berbanding [Sumber B mengklaim Y], disertai analisa penyebab perbedaan: perbedaan periode waktu, perbedaan metodologi riset, atau bias kepentingan.
3. BUKTI YANG TIDAK MEMADAI: Klaim mana yang tidak didukung data primer atau hanya bersandar pada satu kutipan sepihak.
4. PRIORITAS VERIFIKASI: Maksimal 5 poin data yang paling kritis dan wajib diperiksa ke naskah asli beserta konsekuensinya jika klaim tersebut gugur.
5. KESIMPULAN TEGAS: Pisahkan secara hitam-putih menjadi 'Dapat Disimpulkan Sekarang' dan 'Belum Dapat Disimpulkan / Masih Meragukan'.

ATURAN KETAT:
- Jika sebuah angka hanya tercantum di satu sumber, beri label [Belum Terkonfirmasi Independen].
- Jika dua sumber sebenarnya mengutip siaran pers sekunder yang sama, catat bahwa keduanya bukan dua bukti terpisah.

SUMBER DOKUMEN:
[Tempelkan 3-5 teks sumber yang memuat perbedaan data di sini]
Skenario 3: LONG TASK (Stabilitas Konteks dan Manajemen Regresi 5-Turn)
Jalankan lima giliran (turn) ini berurutan dalam satu percakapan. Skenario ini menguji apakah model melacak dependensi keputusan saat batasan proyek diputarbalikkan di tengah jalan.
[TURN 1]
Kita akan merancang arsitektur sistem backend secara bertahap. Jangan kerjakan semuanya sekarang.
TOPIK: [Contoh: Rencana migrasi database relasional monolitik ke arsitektur event-driven terdistribusi].
Komponen yang harus Anda buat sekarang:
1. Rencana 5 fase kerja berurutan beserta kriteria selesainya.
2. Log Keputusan (Decision Registry) berbentuk tabel: No | Pilihan Desain | Alasan Teknis | Komponen Terdampak. (Biarkan tabel kosong untuk saat ini).
Berhenti setelah menampilkan rencana dan tabel log kosong.

[TURN 2]
Kerjakan detail teknis Fase 1 dan Fase 2. Isi dan tampilkan Log Keputusan mutakhir berdasarkan pilihan arsitektur yang Anda putuskan pada kedua fase ini.

[TURN 3 - UJI REGRESI]
Perubahan batasan mendadak dari manajemen: [Contoh: Anggaran infrastruktur cloud dipangkas 60%, sehingga managed Kafka dan message broker berbayar dilarang digunakan, wajib beralih ke lightweight queue lokal atau mekanisme CDC PostgreSQL].
Lakukan berurutan:
1. Sebutkan baris nomor berapa saja di Log Keputusan yang batal akibat aturan baru ini.
2. Jelaskan komponen mana yang tetap aman dan tidak terpengaruh.
3. Revisi rancangan arsitektur khusus untuk bagian yang terdampak, lalu tampilkan Log Keputusan terbaru.

[TURN 4]
Lakukan audit kritis mandiri terhadap seluruh rancangan sejauh ini. Temukan minimal 2 titik kelemahan atau inkonsistensi yang mungkin timbul akibat perubahan di Turn 3. Jika menurut Anda tidak ada celah, sebutkan metodologi validasi yang Anda gunakan.

[TURN 5]
Tanpa melihat ringkasan panjang sebelumnya: sebutkan 3 keputusan paling berisiko yang telah kita ambil beserta alasannya, lalu lanjutkan ke persiapan eksekusi Fase 3.
8. Rubrik Penilaian Objektif (Skala 1 sampai 5)
Gunakan matriks penilaian di bawah ini untuk menilai hasil pengujian secara numerik. Setiap kriteria dinilai dari angka 1 (sangat buruk) hingga 5 (sangat baik), dengan skor total maksimal 25 poin per model.
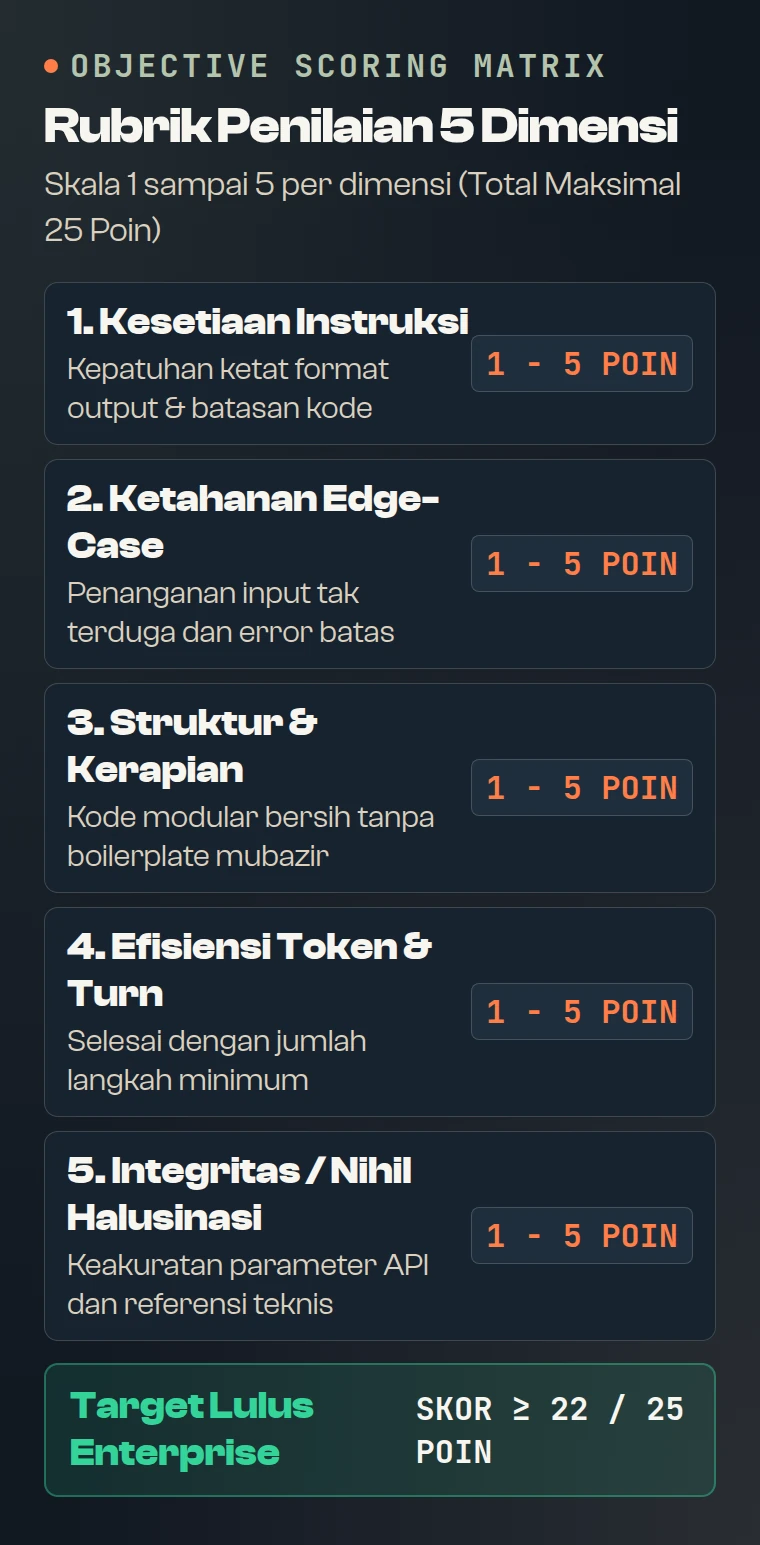
| Dimensi Penilaian | Bobot Tolok Ukur | Indikator Skor Rendah (1-2) | Indikator Skor Tinggi (4-5) |
|---|---|---|---|
| 1. Akurasi & Eksekusi | Validitas kode dan presisi data | Kode memiliki sintaks rusak, dependensi halusinasi, atau angka rekaan. | Kode langsung berfungsi tanpa perbaikan manual, data numerik presisi. |
| 2. Kepatuhan Batasan | Kedisiplinan mengikuti prompt | Melanggar batas pertanyaan, mengabaikan larangan format, jawaban keluar jalur. | Mematuhi seluruh batasan instruksi, format terstruktur rapi sesuai permintaan. |
| 3. Ketahanan Konteks | Memori dependensi lintas-turn | Menulis ulang rencana dari nol saat ada perubahan, melupakan batasan lama. | Mengidentifikasi baris log keputusan yang terdampak secara akurat dan merevisi titik itu saja. |
| 4. Efisiensi Turn & Token | Produktivitas per interaksi | Membutuhkan banyak repetisi dan koreksi pengguna untuk mendapatkan hasil jadi. | Memberikan hasil tuntas dalam langkah minimal tanpa pengulangan teks yang tidak perlu. |
| 5. Kejujuran Epistemik | Penanganan data yang tidak pasti | Bersikap terlalu percaya diri pada klaim sepihak yang belum terverifikasi. | Tegas menandai celah bukti, berani mengatakan “belum dapat disimpulkan”. |
9. Kapan Memilih Opus 5.5, Fable 5.1, atau Sonnet 5?
Anthropic kini merekomendasikan Claude Opus 5.5 sebagai titik tolak utama (default starting point) untuk hampir seluruh beban kerja enterprise dan rekayasa berat. Namun pembagian peran antar keluarga model tetap memiliki batas yang jelas:
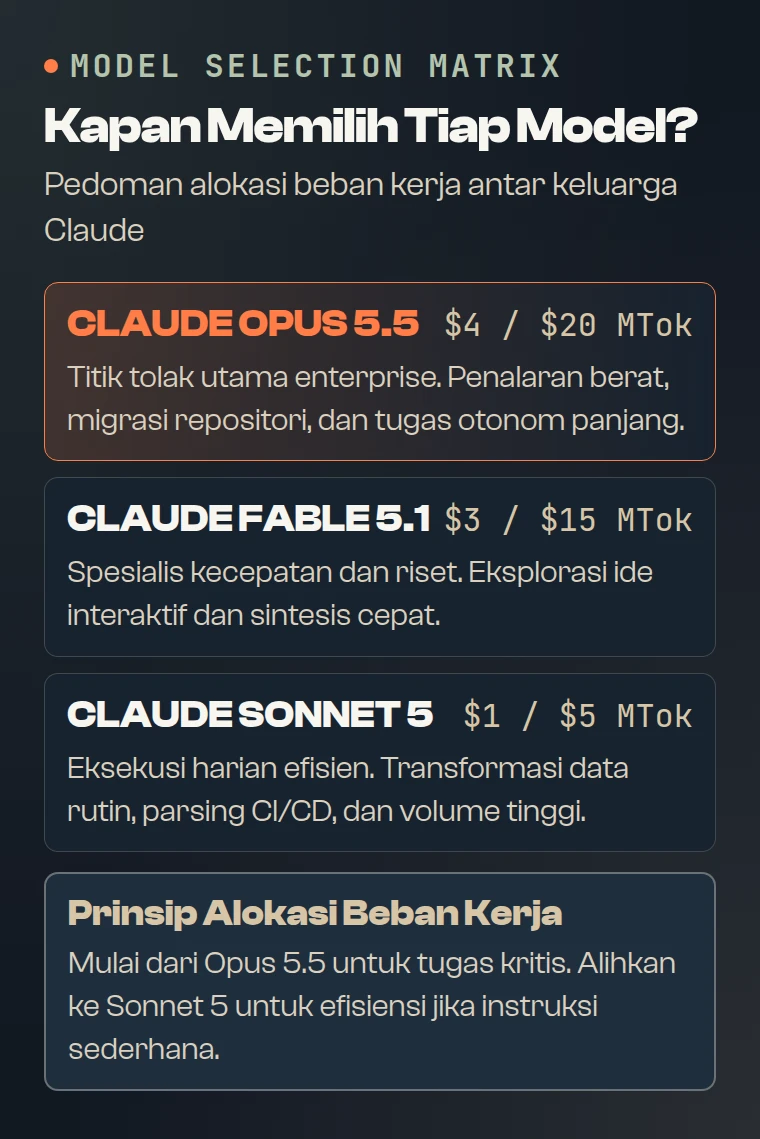
- Pilih Claude Opus 5.5: Untuk tugas rekayasa perangkat lunak multi-file, arsitektur sistem, sintesis dokumen hukum/riset multi-sumber, audit angka finansial, dan agen otonom harian. Ini adalah sweet spot performa dan biaya.
- Pilih Claude Fable 5.1: Hanya jika pengujian mendalam pada Opus 5.5 (dengan parameter effort
highataumax) masih belum memadai. Fable 5.1 diperuntukkan bagi penalaran teoritis paling ekstrem atau pemecahan kode yang membutuhkan penjelajahan pohon logika sangat dalam, dengan biaya 2,5 kali lipat lebih mahal. - Pilih Claude Sonnet 5: Untuk beban kerja volume sangat masif, chatbot interaktif cepat, tugas pemrosesan teks berpola tetap, atau peran subagent pembantu (worker nodes). Harganya separuh dari Opus 5.5 dengan latensi generasi yang jauh lebih gesit.
10. Catatan Teknis API dan Migrasi Pengembang
Bagi tim teknis yang mengintegrasikan Claude Opus 5.5 melalui SDK Anthropic, perhatikan empat perubahan mendasar berikut agar tidak mengalami kegagalan sistem:
- Forced Tool Use Ditolak: Parameter
tool_choicedengan tipeanyatau penentuan satu nama tool spesifik kini mengembalikan status HTTP 400. Gunakan konfigurasiauto, lalu arahkan kebutuhan pemanggilan tool melalui instruksi sistem prompt atau gunakan fitur structured outputs. - Kategori Penolakan Reasoning Extraction: Permintaan prompt yang memaksa model mencetak seluruh isi proses berpikir mentahnya ke dalam teks jawaban dapat memicu penolakan reasoning extraction. Penolakan ini dikembalikan sebagai respons HTTP 200 normal dengan status
stop_reasontertentu, bukan sebagai exception error. Kode backend Anda wajib memeriksastop_reasonsebelum mengurai isi teks. - Pembaruan Tool Computer Use: Versi tool lama
computer_20251124telah didepresiasi pada Claude API dan Google Cloud. Perbarui integrasi otomasi GUI Anda kecomputer_toolset_20260801. - Pemisahan Tipe Blok Konten: Teks yang ditulis model di sela-sela pemanggilan tool kini dikembalikan sebagai blok bertipe
thinking, bukantext. Pengurai antarmuka Anda harus membacablock.type === 'text'secara eksplisit agar layar tampilan tidak kosong selama proses komputasi berlangsung.
11. Sumber Rujukan dan Kredit
Informasi teknis dan perbandingan dalam panduan ini dirangkum berdasarkan dokumentasi resmi serta bahan rujukan publik berikut:
- Dokumentasi Primer Anthropic:
- Kredit Sumber & Inspirasi: Kerangka pemikiran pengujian dan penyajian data komparatif pada artikel ini merujuk serta diadaptasi secara independen dari ulasan Opus 5.5 Test oleh Holly Natasha. Metrik tolok ukur sintetis bersumber dari data primer peluncuran resmi Anthropic; interpretasi praktis dan skenario uji mandiri dikembangkan secara independen.
- Koleksi Terkait: Akses katalog resep otomasi alur kerja lainnya di Guides & Toolkits Antonius Felix.
12. Video Peluncuran Resmi Claude Opus 5.5
Saksikan video pengumuman resmi peluncuran Claude Opus 5.5 yang dipublikasikan oleh Anthropic melalui kanal resmi produk Claude. Video ini memaparkan positioning Claude Opus 5.5 sebagai model flagship dengan performa setara Fable 5.1 dan efisiensi biaya yang jauh lebih tinggi untuk sesi kerja panjang.